


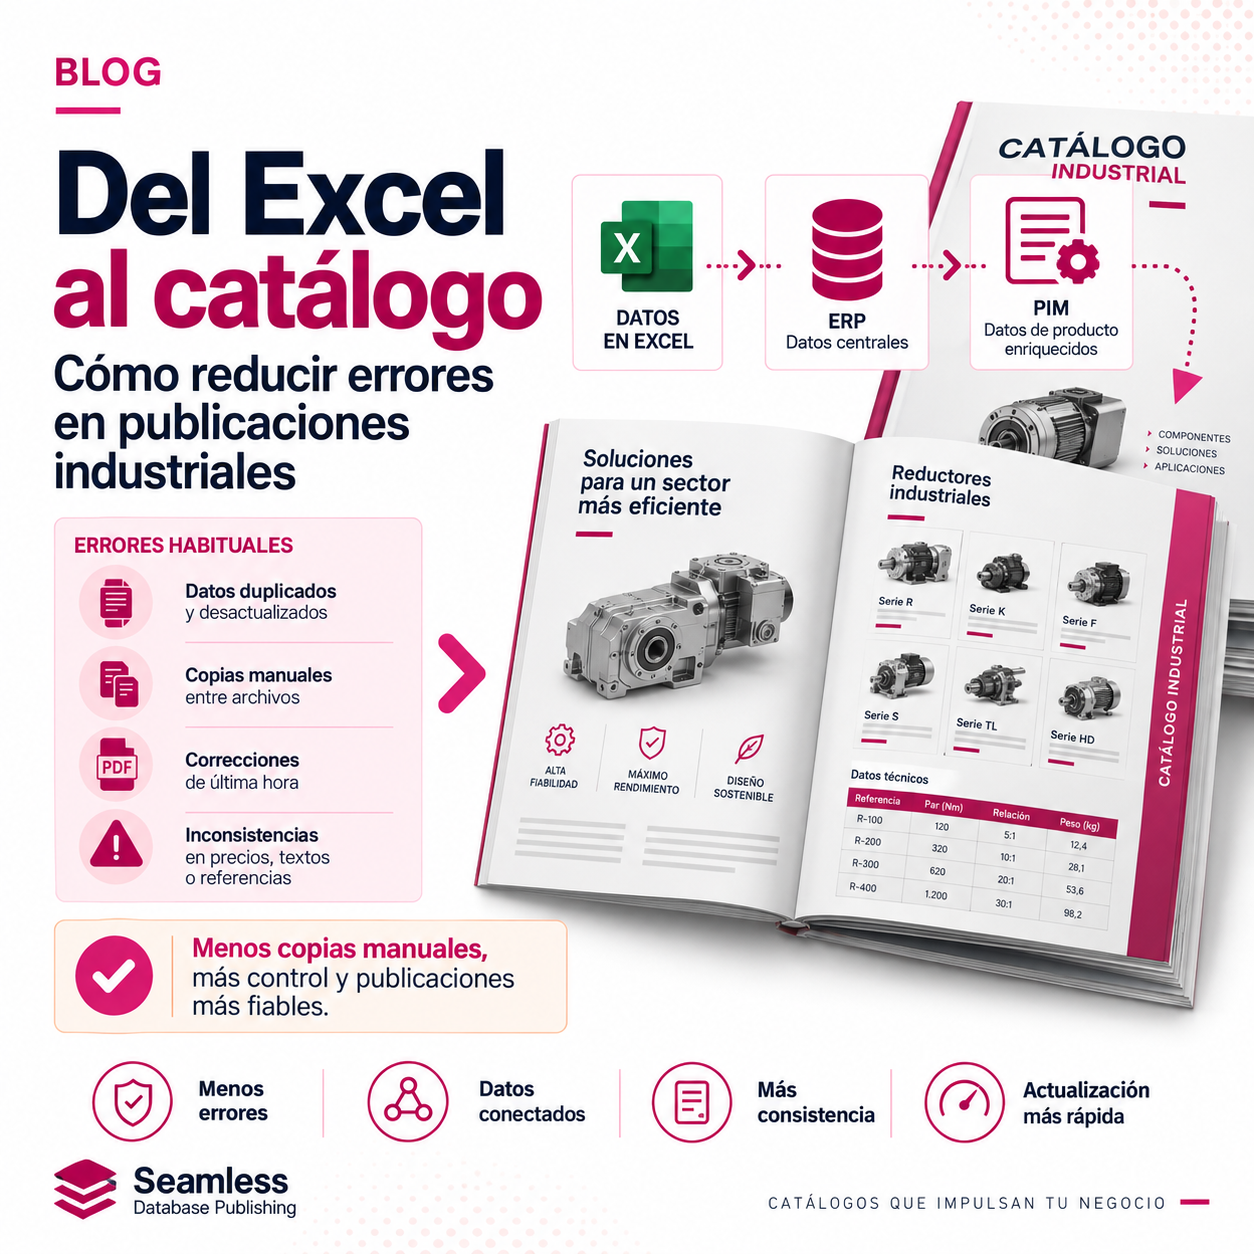
Del Excel al catálogo: cómo reducir errores en publicaciones industriales
Del Excel al catálogo: cómo reducir errores en publicaciones industriales
En un catálogo industrial, un error pequeño puede acabar recorriendo muchas páginas antes de que alguien lo detecte.
Un precio incorrecto. Una referencia antigua. Una unidad mal escrita. Una fotografía que no corresponde.
El problema no suele estar en una herramienta concreta.
Está en todas las veces que el dato se copia, transforma, interpreta o vuelve a introducir manualmente entre su origen y la publicación final.
Por eso, reducir errores en un catálogo no consiste únicamente en revisar más.
Consiste en diseñar un flujo donde la información llegue desde Excel, ERP, PIM o una base de datos hasta InDesign con el menor número posible de intervenciones manuales.
Dónde se originan los errores de un catálogo industrial
Los catálogos industriales suelen combinar grandes cantidades de información:
- referencias de producto,
- precios,
- atributos técnicos,
- unidades de medida,
- tablas,
- imágenes,
- certificaciones,
- idiomas,
- productos relacionados y variantes.
Cuanto mayor es el volumen de información, mayor es también el número de oportunidades de cometer un error si el proceso depende de copiar y pegar datos entre documentos.
En la práctica, muchos errores aparecen durante operaciones aparentemente inocentes:
- copiar una tarifa desde una hoja de cálculo,
- modificar manualmente una descripción dentro de InDesign,
- utilizar una versión antigua de un archivo,
- corregir un dato solamente en el PDF,
- mantener la misma información en varios documentos.
Cada copia crea una nueva versión potencial de la información.
Y cada nueva versión crea otro punto donde el dato puede dejar de coincidir con el original.
Excel no es el problema
Excel puede ser una fuente perfectamente válida para automatizar un catálogo.
El problema aparece cuando existen varios archivos, varias versiones y ninguna regla clara que determine cuál contiene la información válida.
Archivos como:
Tarifa_2026.xlsx
Tarifa_2026_FINAL.xlsx
Tarifa_2026_FINAL_Buena.xlsx
Tarifa_2026_FINAL_Buena_AhoraSi.xlsx
pueden resultar familiares en muchos equipos.
La dificultad no está en el formato XLSX.
Está en la operativa que existe alrededor.
Si Excel va a funcionar como fuente de información, conviene controlar al menos:
- quién puede modificarlo,
- qué representa cada archivo,
- qué versión es válida,
- cómo se identifican productos y variantes,
- qué formatos deben utilizar los campos,
- cómo se registran los cambios.
No necesitas dejar Excel para automatizar. Necesitas una operativa sólida alrededor de los datos.
Por qué un PDF no debería convertirse en una fuente de datos
Un PDF es un excelente formato de distribución.
Pero no debería convertirse en el lugar donde vive la información de producto.
Cuando una corrección se realiza directamente sobre el documento final y no vuelve a la fuente de datos, aparecen dos versiones de la realidad:
la que contiene el sistema de origen y la que aparece publicada.
En la siguiente edición alguien tendrá que descubrir cuál de las dos era correcta.
Por eso, una de las reglas más útiles en un sistema de publicación basado en datos es sencilla:
si el dato está mal, se corrige en origen.
Después se actualiza la publicación.
La importancia de definir una fuente de información
Reducir errores requiere saber qué sistema gobierna cada tipo de dato.
Eso no significa necesariamente que toda la información tenga que vivir físicamente en una única aplicación.
Por ejemplo:
- el ERP puede gobernar referencias y precios,
- el PIM puede gestionar descripciones, atributos, imágenes e idiomas,
- otra base puede contener información específica para publicación.
Lo importante es saber qué fuente tiene autoridad sobre cada campo.
De esta forma, si un precio cambia, no necesitamos preguntarnos qué Excel o qué página debemos modificar.
Sabemos dónde se corrige.
Cuándo aporta valor un PIM en la producción de catálogos
Un PIM (Product Information Management) es un sistema diseñado para centralizar, enriquecer y gobernar información de producto.
Resulta especialmente útil cuando la empresa gestiona:
- muchas referencias,
- numerosos atributos,
- varios idiomas,
- diferentes mercados,
- múltiples canales de publicación.
Pero tener un PIM no automatiza por sí solo un catálogo.
Para aprovecharlo editorialmente, los datos deben estar estructurados teniendo en cuenta cómo se utilizarán después.
Una implantación PIM puede estar perfectamente conectada con ecommerce, marketplaces o feeds y, aun así, obligar a producir el catálogo manualmente si nadie ha previsto la salida hacia InDesign.
El dato no solo tiene que estar bien guardado. Tiene que estar preparado para ser utilizado en todos sus canales.
Qué es la publicación basada en datos y cómo reduce errores
La publicación basada en datos consiste en conectar una fuente estructurada de información con una plantilla editorial para generar o actualizar documentos sin volver a introducir manualmente los contenidos.
En lugar de copiar un precio desde el ERP y pegarlo en InDesign, el campo de precio de la publicación está vinculado a su fuente.
En lugar de modificar una descripción en varias páginas, se actualiza el dato correspondiente y se sincronizan las publicaciones que lo utilizan.
Esto reduce especialmente tres tipos de error:
- errores de transcripción, al eliminar copias manuales;
- inconsistencias, al utilizar una fuente controlada;
- versiones desactualizadas, al poder comprobar si el documento sigue sincronizado con los datos.
La automatización no garantiza que el dato de origen sea correcto.
Pero sí puede reducir drásticamente las oportunidades de introducir nuevos errores durante el proceso editorial.
Automatizar también significa validar los datos
Un buen sistema de automatización no debería limitarse a mover información más rápido.
También debería ayudar a detectar cuándo algo no cumple las reglas previstas.
Por ejemplo:
- un producto sin referencia,
- un precio vacío,
- una imagen inexistente,
- un atributo fuera del rango esperado,
- una combinación de datos imposible,
- un campo obligatorio sin completar.
Estas validaciones permiten detener o señalar el problema antes de que llegue al documento final.
Por eso, una métrica interesante en un proyecto de automatización no es únicamente cuánto tiempo hemos ahorrado.
También es cuántas oportunidades de error hemos eliminado del proceso.
El papel de Adobe InDesign y EasyCatalog
Adobe InDesign proporciona el entorno de diseño y composición editorial.
EasyCatalog añade una capa de conexión entre ese diseño y las fuentes de datos.
Mediante esta combinación es posible crear relaciones entre campos de datos y elementos de la maqueta, además de definir reglas para:
- textos,
- imágenes,
- tablas,
- precios,
- variantes,
- familias de producto,
- elementos condicionales,
- paginación.
Esto permite conservar el control creativo de InDesign sin obligar al diseñador a introducir manualmente cada dato.
La clave está en diseñar plantillas preparadas para automatización.
La creatividad no desaparece cuando aparecen reglas. Simplemente empieza a trabajar dentro de un sistema reproducible.
Cómo cambia el flujo de trabajo cuando los datos están conectados
En un proceso manual, un cambio suele recorrer varios pasos:
dato → correo → Excel → diseñador → InDesign → revisión → corrección
En un sistema conectado, el flujo puede simplificarse:
dato → validación → actualización → revisión
El equipo sigue revisando el catálogo.
La diferencia está en qué revisa.
En lugar de comprobar constantemente si alguien copió mal un precio, puede concentrarse en excepciones, calidad del contenido y resultado editorial.
Marketing, Producto y Diseño siguen siendo necesarios.
Pero intervienen donde realmente aportan valor.
Qué revisar antes de automatizar un catálogo industrial
Antes de conectar una fuente de datos con InDesign conviene comprobar:
- qué sistema gobierna cada tipo de información,
- si referencias y códigos son únicos y estables,
- si atributos y nomenclaturas están normalizados,
- cómo se relacionan familias y variantes,
- cómo se identifican las imágenes,
- qué excepciones existen en el diseño,
- qué validaciones deben realizarse antes de publicar,
- quién modifica, valida y aprueba cada información.
No es necesario resolver todo antes de comenzar.
Pero sí conocer el estado de partida.
Por eso, en proyectos complejos resulta especialmente útil comenzar con una muestra real de productos y validar el flujo antes de extender la automatización al catálogo completo.
Preguntas frecuentes sobre errores y automatización de catálogos industriales
¿Excel sirve para automatizar un catálogo?
Sí. Excel puede utilizarse como fuente de datos siempre que exista una estructura coherente, criterios claros de versionado y una operativa controlada. No es obligatorio disponer de un PIM para automatizar un catálogo.
¿Es necesario tener un PIM para conectar datos con InDesign?
No. Los datos pueden proceder de Excel, CSV, ERP, bases de datos o un PIM. La elección depende del volumen, complejidad, número de canales y necesidades de gobierno de la información.
¿EasyCatalog corrige automáticamente los datos incorrectos?
No. EasyCatalog permite conectar, transformar, validar y publicar datos siguiendo reglas definidas, pero no puede determinar por sí solo si una información de origen es comercial o técnicamente correcta. Esa responsabilidad debe estar definida en el sistema y en los procesos de la empresa.
¿Cómo reduce errores la automatización editorial?
Reduce la necesidad de copiar y volver a introducir información manualmente, permite utilizar fuentes controladas, facilita la sincronización del documento con los datos y permite incorporar validaciones antes de publicar.
¿Automatizar significa dejar de revisar el catálogo?
No. El equipo sigue realizando control editorial. La diferencia es que puede dedicar menos tiempo a comprobar copias manuales y más a validar excepciones, calidad de datos y resultado visual.
¿Qué ocurre si un dato cambia después de maquetar el catálogo?
En un sistema basado en datos, el cambio se realiza en la fuente correspondiente y posteriormente se sincroniza con la publicación. Esto evita tener que localizar y modificar manualmente cada aparición del mismo dato.
Conclusión: menos copias, menos oportunidades de error
Reducir errores en un catálogo industrial no consiste en añadir más rondas de revisión al final del proceso.
Consiste en reducir la cantidad de lugares donde esos errores pueden aparecer.
Excel puede seguir formando parte del flujo.
Un PIM puede centralizar y enriquecer la información.
El ERP puede seguir gobernando precios y referencias.
InDesign puede seguir ofreciendo todo el control creativo que necesita Diseño.
La diferencia aparece cuando esas herramientas dejan de funcionar como islas.
Cuanto menos tenga que copiarse manualmente un dato entre su origen y el catálogo, menos oportunidades existen de que algo salga mal.
¿Quieres ver cómo funciona en un catálogo real?
En Seamless Database Publishing conectamos información procedente de ERP, PIM, Excel y otras fuentes con Adobe InDesign mediante EasyCatalog y automatizaciones específicas para cada proyecto.
El objetivo no es únicamente publicar más rápido.
Es construir un flujo donde los datos sean más fáciles de mantener, validar y actualizar.
